登录社区云,与社区用户共同成长
邀请您加入社区
更准确的定位是一组。UI PolishAnimation并不是需要运行数据库或 Web 后端的传统项目。如果只是个人使用,直接本地安装即可;如果平时已经使用 Claude Code、Codex 等工具搭建远程 AI Coding 环境,也可以把它作为工具链的一部分安装到 Linux 服务器。莱卡云可以作为这种远程开发环境的一个候选,用来承载 Git、Node.js、Coding Agent、Doc
小范围内部测试通过后,仍应在灰度阶段重新评估 LLM 文档或代码辅助工具的并发、成本和用户体验。放量比例应由团队的风险承受能力与观测结果决定,而非固定数字。灰度阶段需要把模型调用、用户行为和资源使用放在同一口径里观察。上下文裁剪、缓存和请求限制是否有效,应通过实际任务和回退结果验证。灰度阶段的核心误区,是将灰度放量单纯理解为“测试服务器吞吐压力”。对于基于大语言模型的 AI 效率工具而言,非确定性
更准确的定位不是传统知识库,也不是普通 PDF 摘要工具,而是一个**“文档 → Agent Skill 编译器”**。核心框架章节术语PatternCheatsheet之后由 Claude Code、Copilot CLI、Amp 等 Agent 按需读取。如果只是偶尔转换一本书,本地电脑已经足够;如果希望长期保存大量 Skill、远程运行 Agent,或者把项目文档和技术资料统一放进开发工作流
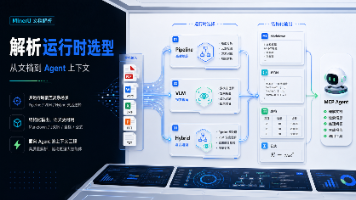
文档解析技术正从单一转换发展为可调度的工程能力,MCP、RAG和科研Agent推动其进入协议层和运行时策略阶段。MinerU作为智能文档解析平台,通过多入口(CLI、Open API、SDK等)和多后端(pipeline、VLM等)支持结构化输出,强调解析策略对OCR质量、隐私、成本等的影响。Agent时代需将解析后端升级为上下文生产策略,根据文档类型、密级等动态选择运行时。RAG效果依赖解析阶段
摘要: HermesAgent是由NousResearch推出的开源智能体框架,旨在解决传统工具难以随时间演进的问题,强调智能体的长期适应性和自我优化能力。其核心优势包括持久记忆、定时任务、多平台接入及自我改进技能,支持Python/ML生态并兼容多种模型供应商。相比OpenClaw,Hermes在图形界面、技能稳定性及多智能体协作上更优;而对比ClaudeCode等编码工具,它更注重长期任务执行
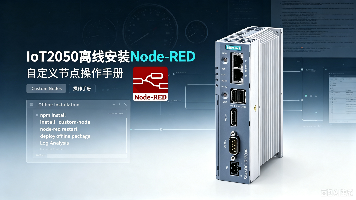
摘要: 本文详细介绍了在无外网环境的西门子IoT2050设备上离线安装Node-RED自定义节点的方法。核心步骤包括:1)在同架构(Linux-arm64)联网机器(或Docker模拟环境)通过npm install打包节点及完整依赖;2)通过SCP将节点文件夹传输至IoT2050的/root/.node-red/node_modules/目录;3)重启Node-RED服务。重点解决了跨架构二进制
MCP(Model Context Protocol)是由 Anthropic 于 2024 年底提出的开放协议,旨在标准化大语言模型与外部数据源、工具之间的交互方式。它定义了客户端与服务器之间的通信规范,让 AI 应用能够以统一的方式发现、调用和管理外部能力。title: "代码审查",description: "对指定代码进行审查",arguments: [{ name: "code", de
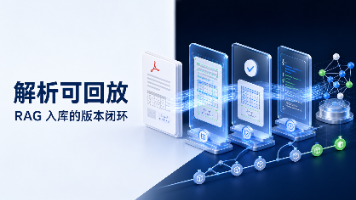
MCP 正在把工具结果推向带 schema 的结构化内容,科研数据平台也在强调 Agent 可直接消费的 AI-Ready 全文。于是,文档入库的关键不再是“这次能不能解析成功”,而是半年后能否解释、复跑并安全升级。MinerU 的 Markdown、JSON、元素资产与多入口能力,适合成为这条版本链的解析层。
这篇文章介绍了跨平台开源的「察元AI文档助手」如何在macOS和Linux系统上快速安装使用。文章通过四个清单详细说明了安装前的准备事项、一行命令安装方法、服务验证步骤以及平台差异注意事项。该工具通过MCP协议提供46个文档处理功能,包括错别字检查、表格编辑等,支持Claude Code、Cursor等AI工具调用,安装过程简单且支持自动更新。特别强调了Mac/Linux用户无需依赖Windows
在熙瑾会悟的研发过程中,我们最近碰到一个比较有意思的问题:如何把已有的语音转写、会议纪要、知识库等能力接入 OpenClaw,让 Agent 不只是“会聊天”,而是真正能够调用业务能力。
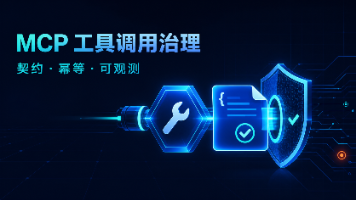
Agent 演示时能查询天气、创建工单,接入生产后却出现另一幅景象:同名工具选错,金额字段传成字符串,超时后重复下单,权限拒绝被模型当成“再试一次”,最终回答还声称操作已经完成。把这些问题统称为“模型不稳定”,通常只会得到更长的提示词,却没有形成可验证的工程边界。MCP 解决的是工具发现与调用协议,不会自动替开发者完成参数校验、授权、审批、幂等、超时恢复和审计。本文用一个可运行的转账工具契约,拆解
Agentic AI、RAG和MCP等技术正推动文档处理进入新阶段,文档不再仅是模型附件,而是转化为可调用、可追溯的数据资产。MinerU平台通过PDF解析、OCR、表格提取等功能,构建了Agentic IDP基础设施,将文档中的段落、表格、公式等元素转化为结构化数据,支持RAG、Agent和科研数据处理。其核心在于提升文档结构化质量,确保数据可治理、可验收,并通过多格式输出和API接入,满足企业
智能项目管理与 AI 辅助决策是提升研发效率的工具,但也需要构建配套的防护防线。高并发接入前,完成 Rate Limit 与租户隔离。为模型调用建立确定性的状态机与超时熔断。数据复盘时,保留降级样本并单列报告其影响。保持底线的确定性,才能防范并发风险,获得可信的验证结论。
const指针:介绍const修饰指针的四种用法,包括指针常量、常量指针及双重const限制,强调初始化要求。 void万能指针:说明void作为通用指针的特性,演示与具体类型指针的转换及memcpy函数实现,包含内存重叠处理示例。 结构体详解:涵盖结构体声明、变量定义、初始化、成员访问(直接和指针方式)、内存对齐规则(含#pragma pack用法)及结构体作为函数参数的传递方式(值传递与地址传
MCP 客户端出现 Connection closed、启动失败或超时,并不等于 Server 本身已经崩溃。本文给出的判断结果是:先确认客户端读取的配置能否解析,再定位到配置入口、传输方式、comm
MCP 2026-07-28规范将文档解析纳入Agent工程的治理范畴,要求对PDF、Office等文件的解析需通过预算门禁管控,包括权限、额度、结构标准等。MinerU平台提供多生态入口(CLI、SDK、MCP Server等),支持分层解析与结构化输出(Markdown/JSON/LaTeX),并强调失败回放与审计追踪。解析预算门禁需结合入口分层(CLI/API/SDK)、结构分层(OCR/表
随着越来越多的大语言模型投入实际开发,很多团队都会同时接入 OpenAI、Anthropic、Google Gemini、DeepSeek、OpenRouter 等多个模型平台。不同模型在价格、响应速度、上下文长度和擅长任务方面各有特点,因此如何统一管理模型调用逐渐成为AI应用开发中的一个常见问题。是一个开源AI模型路由平台,主要用于统一管理多个大模型提供商,对外提供一致的API接口,并根据配置选
LangChain 这东西,说难不难,说简单也不简单。概念是挺多,但核心就那几个组件:Prompt 模板、模型调用、链式组合、记忆、检索、工具调用。一个一个啃,啃完串起来就通了。原生 API → Prompt Template → Chain → Memory → Retriever → Agent。别跳着学,基础打牢比啥都强。还有就是多看官方文档,虽然英文的但更新快,比网上那些东拼西凑的教程靠谱
Ollama 降低了本地运行大语言模型的门槛。它不仅适合个人开发者进行模型实验,也适合企业搭建内网 AI 应用。Ollama模型服务业务API服务Prompt模板向量数据库日志和监控如果项目只需要简单问答,可以直接调用/api/chat。如果需要企业知识库,则应当结合嵌入模型和向量数据库构建 RAG。如果需要复杂的多步骤任务,还可以进一步接入 LangChain、LangGraph 或 MCP。
本文介绍一套适配国产企业级数据库的 MCP 服务解决方案,依托 MCP 协议在 AI 开发工具与数据库之间搭建安全中间服务层,封装 9 类标准化数据库操作工具,覆盖库表结构查询、SQL 执行与执行计划解析、数据库健康巡检、虚拟索引模拟优化四大核心业务场景
║文件目录: C:\Users\test\mcp_demo_files║。║• list_files - 列出文件║。║• list_files - 列出文件║。║• search_files - 搜索文件║。一、MCP server。
memmove是安全的内存移动函数,支持重叠区域。与memcpy的区别仅在于重叠处理,但牺牲了极小的性能。当不确定内存是否重叠时,总是优先选择memmove。属于 C 标准库,可移植性好,是处理内存块移动的首选工具。掌握memmove有助于编写健壮的底层内存操作代码。
第一,目录结构是懂项目边界的。它可以从 Git URL、ZIP 包、本地目录导入仓库,生成结构化 wiki、README 摘要、多语言内容、思维导图和可选 Graphify 产物,再把同一份知识复用到公开文档站、内置聊天、嵌入式聊天 API 和 MCP 端点里。OpenDeepWiki 的价值不在于“AI 自动写文档”这句口号,而在于它已经把代码知识库做成了一条可运营的流水线:导入、分析、目录生成
本文介绍了自定义序列化的核心原理与实践方法。首先解释了序列化与反序列化的概念,即将内存对象与二进制字节流相互转换的过程,并对比了JSON/Protobuf等通用方案的局限性。重点讲解了自定义序列化的五大设计要点:协议结构(包头+包体)、字节序统一、内存对齐处理、兼容性设计和变长数据处理。通过C++代码示例演示了如何正确实现一个用户信息结构体的序列化/反序列化过程,避免直接memcpy结构体的常见错
模型路由抽象:所有模型调用通过统一路由器,切换模型只需改路由配置强制Schema约束:用structured output保证模型输出格式一致性,消除隐式格式依赖效果回归测试集:50-200条标注数据构成回归测试,模型版本切换前必跑数据三级防线:Schema验证+漂移监控+数据血缘,防止数据管道悄悄腐化Prompt四件武器:版本管理+效果抽样+A/B测试+自动回滚,把Prompt当一等公民对待核心
OpenClaw 是 AI Agent Gateway,支持 CLI、常驻 Gateway、Control UI 和多渠道接入。Sandbox 在独立 Docker 容器中执行 Agent 工具,Gateway 仍在宿主机/主容器中运行。OpenClaw、Linux、Docker、Docker Compose、AI Agent、部署。,在 Settings 粘贴 Gateway Token。本文按
MCP 协议的初衷很好——让 LLM 能安全、结构化地调用外部工具。但协议规范和实际 SDK 实现之间,总有一些"约定俗成"的细节文档不会明说。给 LLM 用的接口,描述比实现更重要。你写的代码能跑通只是第一步,让 LLM 能正确理解并调用,才是 MCP Server 真正"可用"的标准。如果你也在开发 MCP Server,建议直接用 MCP Inspector 做一轮完整测试,看看 LLM 拿
Vim这款经典文本编辑器诞生30余年,GitHub星标突破4万。作为Vi编辑器的增强版,Vim由荷兰程序员Bram Moolenaar于1991年发布,凭借独特的三模式设计(普通/插入/命令模式)和键盘操作逻辑,大幅提升编辑效率。其强大扩展性支持Vimscript插件开发,覆盖各类开发场景。Vim跨平台支持广泛,自带详细文档和交互教程。采用慈善软件许可证,鼓励用户捐赠支持乌干达慈善项目。尽管创始人
函数调用、MCP 工具或复杂 JSON Schema 也会进入上下文。工具越多、参数说明越长,请求的固定开销越大。直接删除旧消息虽然简单,却可能丢失用户偏好、业务约束和前面已经确认的结论。稳定事实:用户身份范围、项目约束、输出格式、已经确认的决定;滚动摘要:较早对话压缩成结构化摘要;近期原文:保留最近几轮完整消息和当前问题。目标:当前要完成什么已确认:已经达成的结论约束:不能改变的条件未解决:仍需
先给 Agent 写两个最基础的工具:读文件、写文件,这就是它能直接用的「手脚」。"""读取本地文件"""try:return f"读取失败:{str(e)}""""写入本地文件"""try:return f"写入成功:{file_path}"return f"写入失败:{str(e)}"到这里,我们没有用任何复杂的重型框架,只用了不到 200 行的核心代码,就实现了一个完整可用、能落地干活的 A
Claude Code 能力很强,但新手上手时容易在环境配置、提示词写法、费用控制等方面踩坑。本文整理 10 个高频问题及对应解法,帮你少走弯路。Claude Code 很强,但用好它靠的是习惯:提示词写具体、任务拆小步、改动前留 Git 存档、生成的代码必 review、上生产前先在测试环境验证。把这 10 个坑避开,就能明显减少返工。API 接入方式按自己的网络和计费情况选择即可,官方直连和第
在搭建自动化数据采集系统时,很多开发者往往卡在环境配置和依赖管理的第一步。面对复杂的库版本冲突或是编译报错,原本简单的部署计划很容易变成一场耗时数天的“排雷”行动。特别是当我们需要在一个干净的虚拟机环境中从零开始构建一个稳定的爬虫服务时,系统要求的确认和基础依赖的完整性直接决定了后续工作的顺畅程度。OpenClaw 作为一个轻量级且高效的采集框架,其优势在于结构清晰和扩展性强,但前提是必须有一个稳
通过Annotated[类型, 归约函数]显式指定合并逻辑,最常用在列表场景。→ 列表追加专门用于对话记录、执行日志、消息列表等需要保留历史、向后追加的场景。状态定义:python运行{"log": ["第0轮思考完成"]}{"log": ["第1轮思考完成"]}{"log": ["第0轮思考完成", "第1轮思考完成"]}(新旧列表拼接)支持自己编写合并逻辑(保留最新、去重、条件合并等),规则同
错误做法正确做法直接修改创建进行配置覆盖仅在终端在 systemd 服务的中设置代理重启整个主机restart永远不要手动编辑由程序自动生成的服务文件,应使用 systemd 官方推荐的 drop-in 方式追加配置。
本文从零讲解了 JSON Schema 在接口数据校验中的应用,涵盖 type、required、数组/对象约束、数值与字符串范围、enum 枚举、dependentRequired 依赖等核心关键字,并以博客接口响应校验为综合实战示例,附 12 道问答练习巩固理解。
本文介绍了Agent(智能体)的概念,它是一种基于大语言模型的自主性软件实体,能够感知环境、决策并执行任务。文章重点讲解了链式工作流(Chain Workflow)模式,通过将复杂任务拆解为有序子步骤(如意图识别 → 信息提取 → 答案生成)来提升处理准确率,并提供了一个基于Spring AI的三步链式处理代码示例,展示了从用户输入到最终答案的完整流程。最后强调多Agent协作系统(Agents)
以下为本文档的中文说明Mailchimp 自动化技能是一个通过 Rube MCP 和 Composio 平台实现 Mailchimp 邮件营销平台操作自动化的工具。它的核心功能全面覆盖 Mailchimp 的主要邮件营销工作流:创建和发送营销活动、管理受众和邮件列表、管理订阅者、进行用户分群和细分、以及分析营销活动绩效数据。使用场景主要面向使用 Mailchimp 进行邮件营销的团队,特别是需要批