Java 转大模型开发到底解决了什么问题?
如果你正准备往大模型方向转,《我用Java经验做了次 AI 项目,最先失效的是旧方法》这类问题别只看热度。更重要的是判断自己该补哪块能力,以及怎么证明你真的会。
摘要
去年我做了个判断:Java后端转大模型应用开发,应该是最平滑的路线之一。熟悉Spring、熟悉REST、熟悉数据库,换个LLM API调用不就行了?
三个月后,我亲手接的一个内部Agent项目上线第一天崩了。不是模型调用失败,不是RAG检索出错,是权限配置乱了——一个工具调用接口,能把用户数据读到管理员级别。
这件事让我重新理解了"工程化"三个字。
---
目录
- Java开发者的优势,比你想的要多
- 需要补齐的AI技能,按优先级排序
- Spring AI 和 LangChain4j,怎么选
- 我踩过的权限和日志坑
- 项目练习建议
- 面试准备:证明你懂工程化
- 总结
Java开发者的优势,比你想的要多
别一上来就觉得自己要从零学Python、学Transformer、学注意力机制。大模型应用开发的核心难点,从来不在模型本身,而在把模型塞进生产环境。
Java开发者有几个天然优势:
第一,你对"接口契约"有肌肉记忆。 LLM的输出本质上是非结构化文本,但你怎么把它变成下游系统能消费的结构?JSON Schema、类型校验、异常边界——这些是Java程序员最熟悉的领域。
第二,你懂数据库和事务。 RAG的检索结果要存、要索引、要关联用户权限,这些是传统后端的基本功。
第三,你习惯写测试。 Agent调用链路的可观测性,本质上就是分布式追踪的变体。Spring Boot的Actuator、Micrometer、OpenTelemetry,迁移成本很低。
我见过太多转大模型的程序员,花大量时间学Prompt Engineering,结果项目上线后发现:模型回答得挺好,但权限越界、日志缺失、错误无法追踪。这些才是生产环境的真实成本。
---
需要补齐的AI技能,按优先级排序
我不是说Java技能没用,而是说转型期有明确的学习顺序。我的建议是:
第一优先级:Prompt Engineering + 输出结构控制。 这不是玄学,是工程问题。你需要学会怎么用System Prompt约束模型行为,怎么用JSON Mode或Function Calling让输出可解析。
第二优先级:向量数据库基础。 Pinecone、Milvus、Chroma,选一个用起来。理解Embedding、相似度检索、Chunk策略,这些是RAG的核心。
第三优先级:Agent框架。 Spring AI、LangChain4j、LangGraph,理解它们的抽象层次和适用场景。
第四优先级:模型评估和可观测性。 这不是入门内容,但决定你能不能把项目从Demo变成生产。
很多人一上来就学Fine-tuning、学RAG架构、学GraphRAG,结果基础没打牢,后面全是坑。我的判断标准是:如果你连一个带Function Calling的Agent都写不利索,别碰微调。
---
Spring AI 和 LangChain4j,怎么选
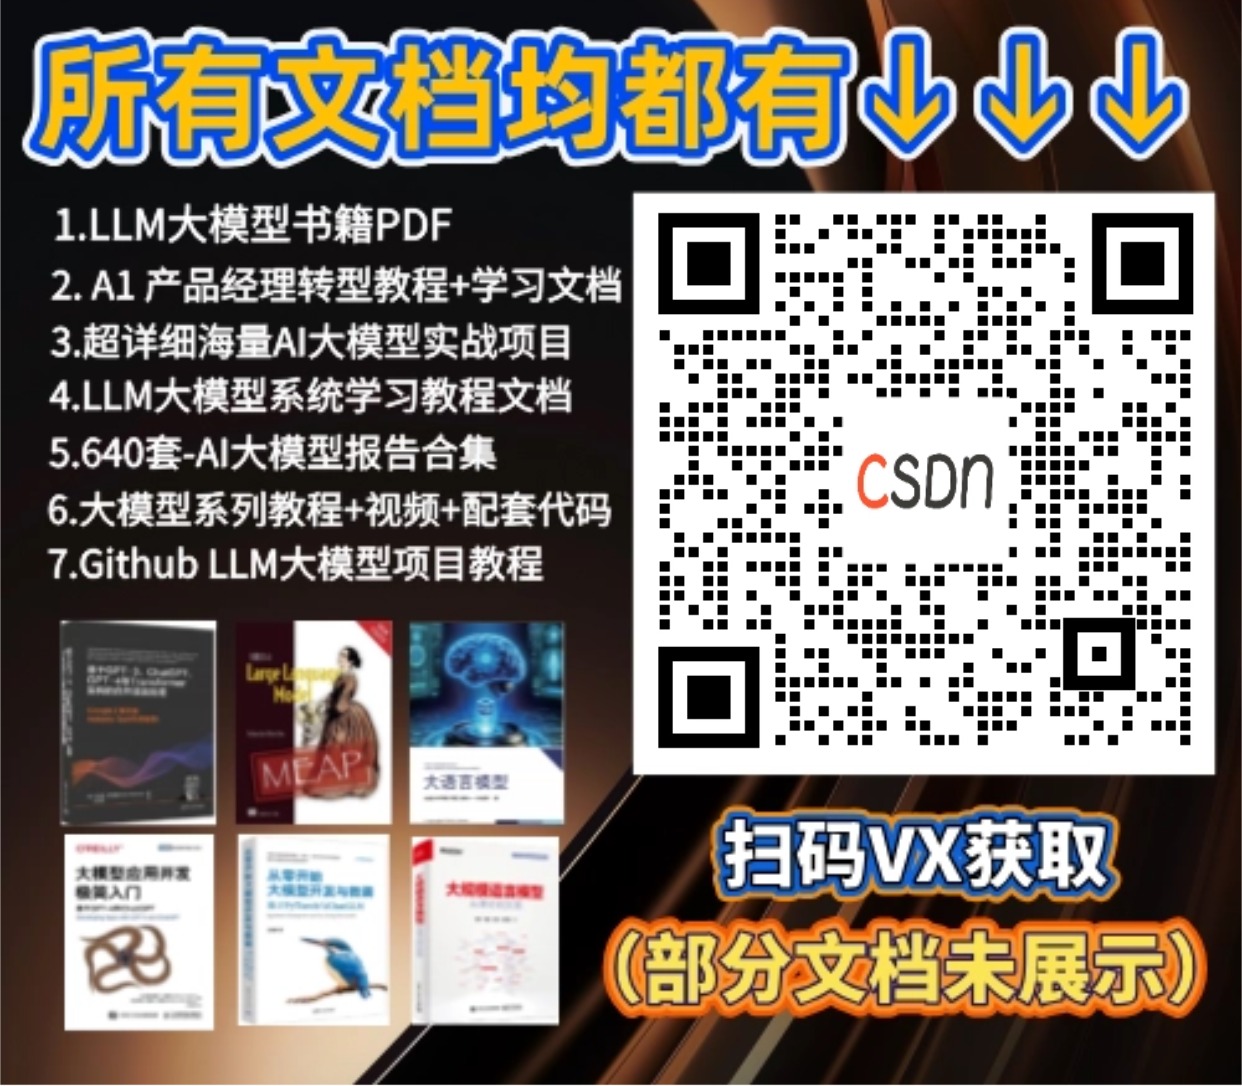
我两个都用过。我的结论是:小团队、快速迭代,选Spring AI;复杂Agent链路、需要精细控制,选LangChain4j。
Spring AI的优势在于和Java生态无缝集成。你用Spring Boot,依赖引入、配置管理、依赖注入,都是熟悉的模式。它提供的PromptTemplate、ChatClient、RAG支持,够用且直观。
LangChain4j的优势在于API设计更贴近LangChain Python版,社区生态更丰富,特别是Agent和Tool的抽象更灵活。
看一个具体例子。我用Spring AI写一个带工具调用的Agent:
@Configuration
public class AgentConfig {

    @Bean
    public ChatClient chatClient(ChatClient.Builder builder) {
        return builder
            .defaultSystem("你是一个数据分析助手,只回答与报表相关的问题。")
            .defaultTools(salesTool, inventoryTool)
            .build();
    }

    @Bean
    public SalesTool salesTool(SalesRepository repository) {
        return new SalesTool(repository);
    }
}

public class SalesTool {

    @Tool(description = "查询销售额,参数:月份(YYYY-MM)")
    public String querySales(@ToolParam String month) {
        List<SalesRecord> records = repository.findByMonth(month);
        return records.stream()
            .map(r -> r.getProduct() + ": " + r.getAmount())
            .collect(Collectors.joining(", "));
    }
}
这段代码的核心逻辑是:定义工具 → 注册到ChatClient → 模型自动决定何时调用。权限控制在哪里?在工具实现里。日志在哪里?需要自己接入。
这就是问题所在。
---
我踩过的权限和日志坑
上线第一天崩的那个项目,我做了三个错误判断:
第一,我以为权限是模型的事。 模型不会越权,它只会按Prompt要求回答。但工具调用会访问真实数据,如果SalesTool直接查数据库,没有用户隔离,就是一个数据泄露接口。
第二,我以为日志是框架的事。 Spring AI和LangChain4j都有基础日志,但Agent的决策链路——为什么模型决定调用这个工具、调用参数是什么、返回结果怎么影响下一步——这些需要自己埋点。
第三,我以为可观测性是后期优化。 上线第一天崩了,我才意识到:没有链路追踪,故障定位成本极高。
正确的做法是:
权限控制前置到工具层。 每个Tool都应该有明确的权限边界,最好能注入当前用户上下文。
@Tool(description = "查询销售额,参数:月份(YYYY-MM)")
public String querySales(
    @ToolParam String month,
    @ToolParam UserContext context
) {
    // 权限校验:用户只能看自己负责的区域
    if (!context.hasPermission(region, "sales:view")) {
        throw new PermissionDeniedException("无权查看该区域销售数据");
    }
    return repository.findByMonthAndRegion(month, context.getRegion());
}
日志要覆盖Agent决策链。 我后来接入了OpenTelemetry,把每次工具调用的输入输出都作为Span记录:
@Component
public class TracedToolExecutor implements ToolExecutor {

    private final Tracer tracer = OpenTelemetry.getTracer("agent-tracer");

    @Override
    public String execute(ToolCall call, UserContext context) {
        try (var span = tracer.spanBuilder("tool.execute")
                .startSpan()) {
            span.setAttribute("tool.name", call.name());
            span.setAttribute("tool.args", call.arguments());
            span.setAttribute("user.id", context.getUserId());

            String result = delegate.execute(call, context);

            span.setAttribute("tool.result.length", result.length());
            span.setStatus(StatusCode.OK);
            return result;
        } catch (Exception e) {
            tracer.getActiveSpan().recordException(e);
            throw e;
        }
    }
}
可观测性不是后期优化,是上线前提。 没有链路追踪的Agent项目,故障定位时间可能是有追踪的10倍以上。
---
项目练习建议
如果你准备转型,我建议做一个有权限控制和完整日志的Agent项目,而不是一个纯Demo。
具体建议:
项目主题: 内部知识库问答Agent,支持多用户、多权限级别。
必须实现的功能:
1. 用户登录鉴权(JWT或OAuth2)
2. 工具调用带权限校验
3. 完整的Agent决策链日志
4. 错误重试和降级策略
5. 简单的性能监控(响应时间、Token消耗)
不要做的事:
1. 不要追求复杂的多Agent协作
2. 不要做Fine-tuning,用Prompt Engineering解决
3. 不要引入过多框架,保持简洁
我见过太多简历上写"基于LangGraph的多Agent协作系统",面试问权限怎么控制、日志怎么追踪,全答不上来。这种项目,HR一眼就看出来是抄的。
---
面试准备:证明你懂工程化
大模型工程师岗位的面试,越来越看重工程化能力。我的建议是:
准备一个能讲清楚的设计决策。 比如:为什么选Spring AI而不是LangChain4j?权限控制放在哪一层?日志怎么设计才能支持故障定位?
准备一段代码。 不要只贴GitHub链接,要能现场解释关键逻辑。面试官问"你的Agent怎么保证不泄露用户数据",你要能说出具体实现。
准备一个踩坑复盘。 我上面写的权限日志崩盘经历,就是最好的面试素材。它证明了你有生产经验,知道Demo和上线的区别。
---
总结
Java转大模型,最大的坑不是技术栈切换,而是思维模式切换。
Demo思维:模型能回答就行。
生产思维:权限、日志、可观测性、错误处理,一个都不能少。
我的判断是:2026年大模型工程师岗位的生死线,不是模型智商,而是权限日志。小团队资源有限,更要避免过度设计,把有限精力放在最影响生产稳定性的地方。
转型不是学新东西,是把旧经验用对地方。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
欢迎加入 MCP 技术社区!与志同道合者携手前行,一同解锁 MCP 技术的无限可能!
更多推荐
 4
 0
- 0


 已为社区贡献9条内容

所有评论(0)