2026最火AI实战系列:多模态AI实战 — 文字+图片+视频统一处理,打造超级Agent!
·
2026年,单模态AI已经不够看了!多模态AI(文字+图片+视频)让Agent真正“看懂世界”。一句话指令,它就能分析图片里的缺陷、总结视频会议内容、生成带图文并茂的报告。本文手把手教你用Qwen-VL / GPT-4o + LangGraph搭建多模态超级Agent,附完整代码、实战案例、部署方案和超多配图Prompt。看完你就能做出让人惊艳的AI作品!
一、2026年,AI终于“睁开眼睛”了!
以前AI只能聊文字,现在它能看图、懂视频、理解现实世界。
想象这个场景: 你拍一张工厂设备的照片,发给AI说“帮我分析这个设备有没有故障”,它立刻识别出异常部位、给出维修建议,还生成带标注的报告。这就是2026年多模态AI的真实力!
二、多模态AI vs 单模态,差距有多大?
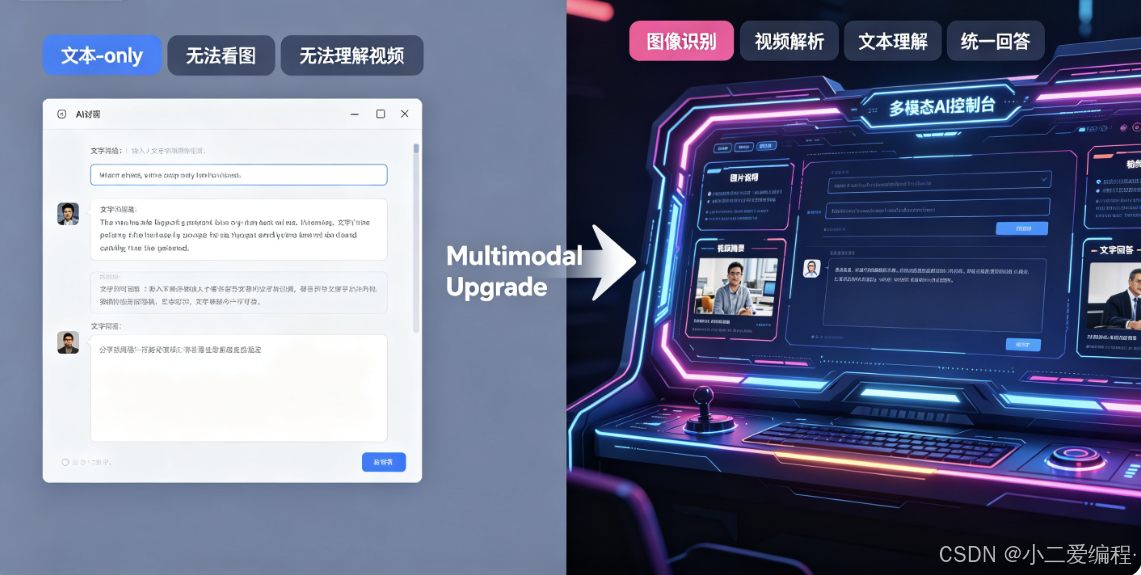
| 维度 | 单模态AI(纯文字) | 多模态AI(文字+图+视频) | 能力跃升 |
|---|---|---|---|
| 信息理解 | 只能读文字 | 看图、懂视频、跨模态推理 | 革命级 |
| 实际应用场景 | 聊天、写文档 | 质检、视频总结、AR辅助 | 极大扩展 |
| 幻觉概率 | 较高 | 大幅降低(视觉 grounding) | 显著 |
| 用户体验 | 抽象 | 直观、图文并茂 | 爽很多 |
2026年,多模态已经成为超级Agent的标配。
三、实战项目:多模态超级Agent
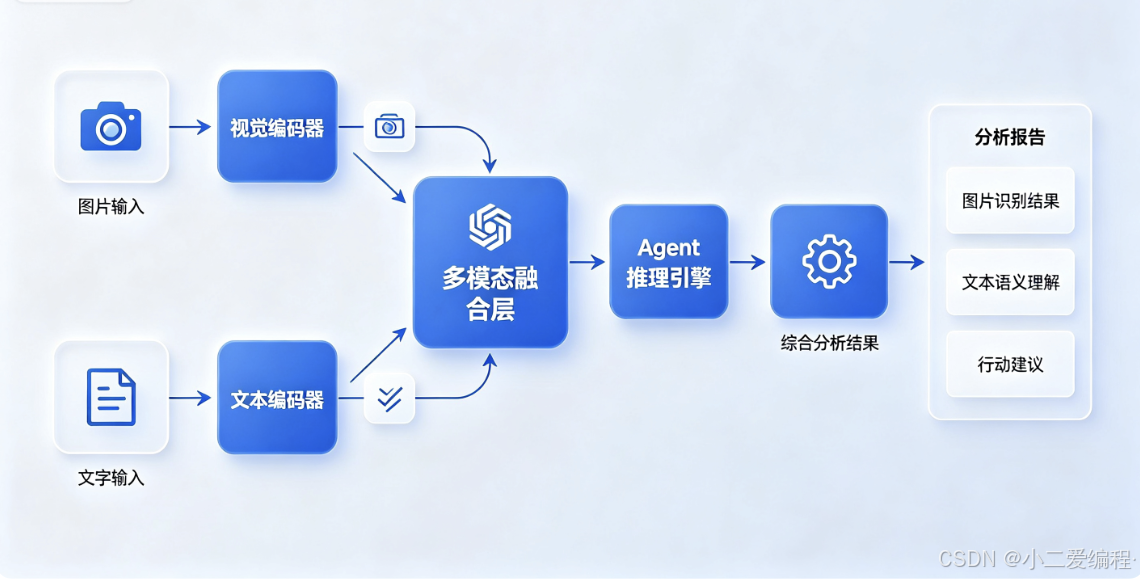
项目效果:上传图片/视频 + 文字指令,Agent自动分析、规划、输出结果。
1. 准备工作
- 使用支持多模态的模型(Qwen-VL-Max推荐,性价比高)
- 安装依赖:langchain langchain-openai pillow opencv-python
2. 完整核心代码(multimodal_agent.py)
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage
from langgraph.graph import StateGraph, END
from PIL import Image
import base64

load_dotenv()

# 多模态LLM
llm = ChatOpenAI(model="qwen-vl-max", temperature=0.5)

def encode_image(image_path):
    with open(image_path, "rb") as image_file:
        return base64.b64encode(image_file.read()).decode('utf-8')

class MultiModalState(dict):
    messages: list
    image_data: str = None
    video_summary: str = None
    final_result: str = None

def vision_analyzer(state):
    # 处理图片
    if state.get("image_data"):
        prompt = "分析这张图片的内容,并回答用户问题。"
        message = HumanMessage(content=[
            {"type": "text", "text": state["messages"][-1]},
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{state['image_data']}"}}
        ])
        response = llm.invoke([message])
        return {"final_result": response.content}
    return state

# 构建Graph
workflow = StateGraph(MultiModalState)
workflow.add_node("vision_analyzer", vision_analyzer)
workflow.set_entry_point("vision_analyzer")
workflow.add_edge("vision_analyzer", END)

app = workflow.compile()

# 使用示例
image_base64 = encode_image("factory_equipment.jpg")
result = app.invoke({
    "messages": ["这台设备有没有潜在故障?请详细分析并给出建议。"],
    "image_data": image_base64
})
print("AI分析结果:", result["final_result"])
视频处理:可结合Whisper提取音频 + 多模态模型总结。
四、常见坑 & 避坑指南
| 坑点 | 后果 | 避坑方法 |
|---|---|---|
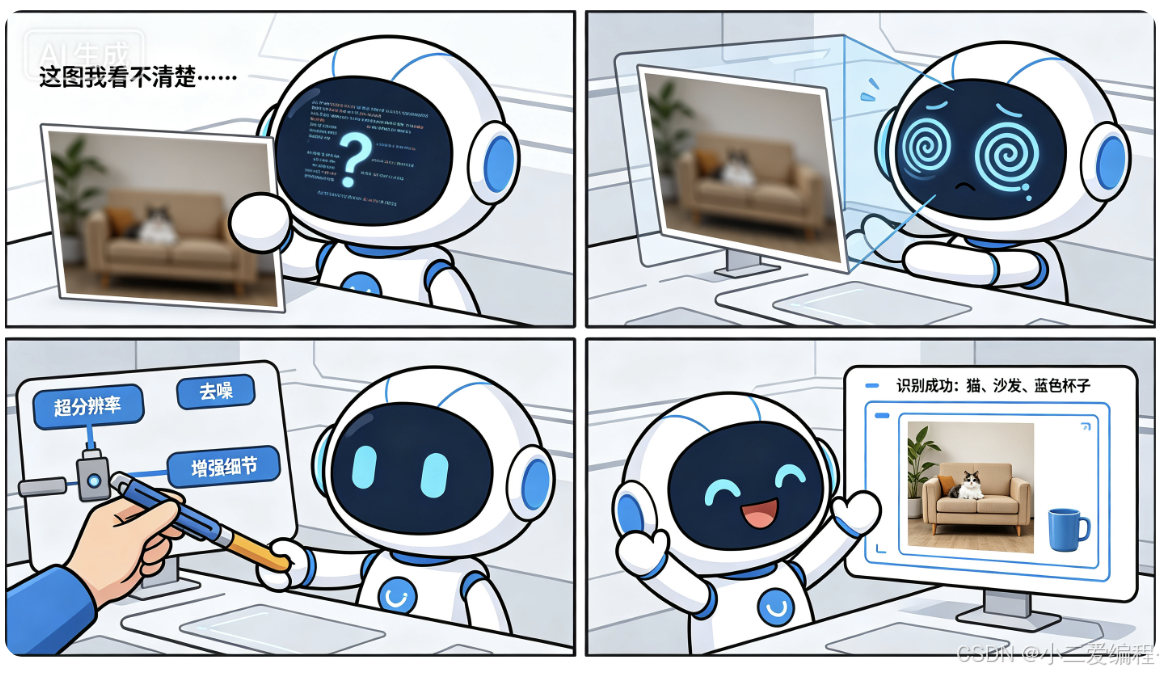
| 图片分辨率过高 | Token超限 | 压缩图片或分块处理 |
| 模型理解偏差 | 分析不准 | 提供Few-shot示例 + 多轮对话 |
| 视频处理慢 | 用户等待太久 | 先用Whisper提取关键帧+音频 |
| 隐私泄露 | 企业不敢用 | 本地部署或私有化模型 |
五、部署与产品化
- 本地:Streamlit快速做出Web Demo
- 企业级:FastAPI + Docker + Kubernetes,支持批量处理
- 进阶:结合RAG做“多模态知识库”,图片也能检索
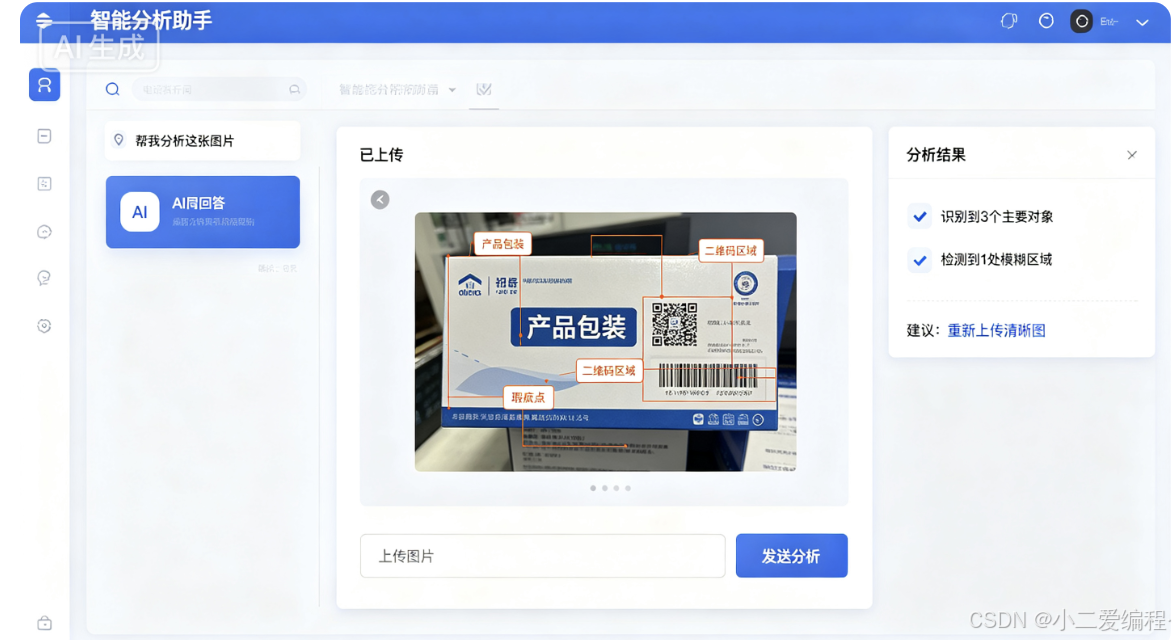
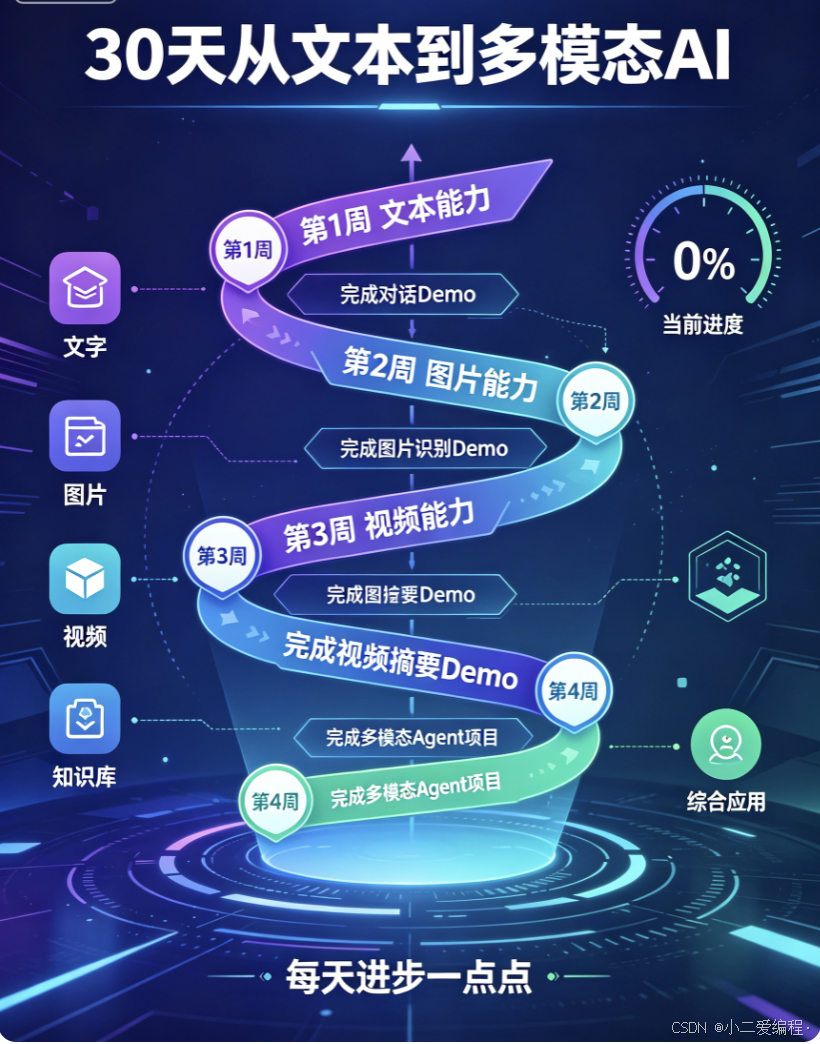
六、30天多模态进阶路线
Week 1:熟悉Qwen-VL / GPT-4o多模态调用 Week 2:LangGraph多模态流程编排 Week 3:视频+音频处理实战 Week 4:完整项目 + 部署优化
七、这波技术红利,你冲不冲?
2026年,多模态AI正在重塑质检、安防、医疗影像、内容创作等无数行业。早掌握,早成为团队核心!
欢迎加入 MCP 技术社区!与志同道合者携手前行,一同解锁 MCP 技术的无限可能!
更多推荐
 7
 0
- 0


 已为社区贡献15条内容

所有评论(0)