写代码的人反而不写代码了?
演进历程:从辅助插件到全能 Agent
从 2024 年下半年起,我开始深度探索 AI 辅助开发。随着工具链的几轮更迭,我的协作模式经历了三个明显的阶段:
• 初探期 (Cursor / Augment Code):告别了早期的 GitHub Copilot,开始感受到下一代 AI 编辑器在理解上下文方面的质变。
• 惊艳期 (Claude Code):这一阶段,AI 解决复杂 Bug 与处理中大型编码任务的能力令我惊艳,尤其是 Claude 3 Opus 发布后,AI 开始具备极强的逻辑推理能力。
• 成熟期 (Codex):自 2025 年 10 月起,我将工作流固定在 Codex。一方面是由于 Claude 封号、降智、缩量;另一方面是 Codex 在高强度任务下的稳定性与大容量供应,配合成熟的工作流,我目前 95% 的编码任务已完全交给 AI 执行。
贴个账单证明不是瞎扯:
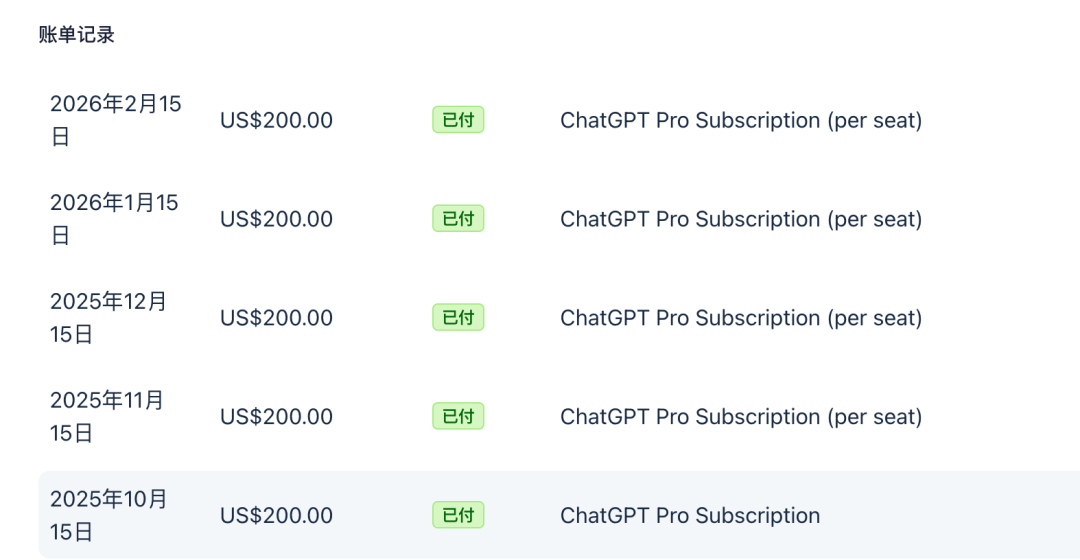
“Humans steer. Agents execute.”(人类掌舵,Agent 执行) —— 正如 OpenAI 在 2026 年初所言,这种协作状态已成为我目前的常态。
可能有读者会质疑为什么我能 95% 的编码都交给 AI?其实这已经不是什么新鲜事,各大 AI 大厂以及海外顶尖大厂的工程师都有不少 blog 来输出类似的观点,开源项目你也能看到不少 Commit 的 coauthor 是 Claude/GPT。
我在创业出海小团队,能用开源就不重复造轮子,同时我自己做全栈,前后端沟通成本低。在上下文给全、工作流跑顺的前提下,95% 的编码都交给 AI 的这个指标是完全可以达成的。
但如果你在大厂,或者项目里有不少闭源依赖,上下文本来就难拿全,AI 输出质量下降很正常。另外,模型本身也有差异。不是 GPT/Claude 这一档时,代码质量通常会明显下滑。
如果你现在用的是 GPT 或 Claude,但仍觉得产出不稳,下面这套 workflow 值得参考。如果你还没认真用过这类模型,强烈建议直接试一方产品。三方中转(例如 Cursor、各种中转商)看起来模型一样,结果经常不一样,核心还是供应方会不会为了成本做降配。
整体流程
目前编码的整体流程主要是先和 AI 聊需求确定方案,然后产出一份设计及 Plan 文档,接下来就是 AI 狠狠干,出业务代码的同时还会把测试代码加上,并且会自动化的进行测试、排查以及修复,最后多 Agent 多维度 Review + 人工 Review 收尾。
编码前
拿到需求后,尤其是中大型需求,不要把几句话扔给 AI 就让它开写。很多人说 AI 不好用,问题往往就出在这一步。
完整上下文非常关键。我们和 PM 对需求都要来回确认几轮,不可能指望 AI 靠几句描述就完全理解需求并能完美执行。
我现在通常先用 https://github.com/obra/superpowers 里的 brainstorming skill,把需求过一遍:补齐遗漏、比选方案、产出设计文档。
然后把设计文档交给 Codex 的 Plan 模式(Claude Code 也有类似能力)。这个模式的价值在于:它会基于代码上下文把执行计划拆清楚,并在关键不确定点主动追问你。最后拿到的 Plan 一般会包含:
• 需求拆解
• 具体实现任务
• 测试用例
• 验收清单
到了这里并不意味着马上需要 AI 介入编写代码。我们首先需要 AI 将这个 Plan 输出成 Markdown 文件,然后需要认真 Review 这份文档,虽然 AI 很擅长理解代码和写方案,但他不知道这个需求到底解决了哪些用户真实的痛点、用户体验怎么做在当下是做好的,亦或是我们目前对于工程的接受度等等。对于这类种种,Review 文档然后做出批作或者直接修改,然后让 AI 循环往复几次一般才能产出一份最终答案。
这个阶段的核心是充当架构师的角色和 AI 共同产出一份对味的 Plan 文档,接下来就是进入监督者的角色静静地看 AI 表演。
编码
文档阶段做完后,进入实现阶段。我通常分两步走:
1. 先让 AI 完成整体验收范围内的功能实现
2. 按 Plan 里的验收清单逐条回归边界条件
如果需求较大,AI 一次跑完会比较慢。这时可以开多个窗口配合 git worktree 并行推进,提高整体吞吐。
对于前端 UI,如果设计师用 Figma,一定要把 Figma MCP 配好,页面还原度在我这里可以达到 90 分。
我自己常用的 MCP 不多,除了 Figma MCP 之外,context7 用得最频繁。其他 MCP 虽然装过,但后来基本停用了。Skill 方面,Vercel 的 vercel-react-best-practices 很实用。其余按需选就行,做 App 或后端可以去 https://skills.sh 挑。
这里聊一下为什么我不喜欢装一大堆 MCP 和 Skill,首先不论这些 MCP、Skill 到底适不适合自己,还有一个很大原因是大模型存在一个上下文问题:Context Degradation(上下文退化),无关的信息对于 AI 是噪声,大段的上下文会导致大模型忽略中间的信息,塞的东西越多越可能塞入错误信息,这些都会使大模型的推理能力降低。
另外对于 MCP 和 skill 不要看都不看就安装,供应链风险一直都在。
测试
测试不能省。
早几年前端测试覆盖率普遍不高,但现在 AI 写代码速度已经远超人工,没理由跳过测试环节。
虽然我把大部分编码交给 AI,但我不会直接信任结果。前面产出的 Plan 通常会带测试用例;如果没有,就先让 AI 把测试补齐再往下走。
前端至少要有端到端测试和关键函数单测。后端同理,覆盖率尽量往高做,我自己的目标一般是 90% 左右。
测试过程本身也包含了大量 debug。以前是我们自己定位问题,再把报错截图给 AI;现在在 AI-friendly 的 infra 下,可以直接让 AI 调用工具自己排查,例如:
• 用 agent-browser 复现前端问题
• 读取 DevTools 报错
• 查看后端日志
• 查询数据库状态
这样定位和修复会快很多,但前提是权限和安全边界要先做好。
Code review
这个环节还是建议真人介入,不 Review 或者只靠多 Agent review 还是不大靠谱。自己的小产品需要快速迭代的话可以省掉这一部分,但是公司的代码还是不能省,毕竟背锅还得你来背,AI 又不能背。
这里的多 Agent review 指的是通过提示词创建多个 Agent 角色各司其职,比如专门负责代码的、性能的、安全的、用户体验的等等,一个角色只做一件事,这样 review 下来的效果会优于单一 review。
部署
每家公司部署细节不同,但主路径一般是稳定的。对这种固定流程,建议直接沉淀成 skill,让 AI 按步骤执行,减少重复手工操作。
我自己的 workflow 里写了不少 skill,因为很多工作本质上就是重复路径。能自动化就自动化,把精力留给真正需要判断的地方。
以上就是我目前这套 AI 编码 workflow。对这类实践感兴趣的话,欢迎交流。

欢迎加入 MCP 技术社区!与志同道合者携手前行,一同解锁 MCP 技术的无限可能!
更多推荐
 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)