解决Linux平台的SPI-CAN(MCP2515)丢帧问题
目录
1. 背景
由于瑞芯微的RK3568/3588的原生CAN有芯片级BUG,所以大多数厂家会采用spi-can方案。
但是实测MCP2515这款芯片会有丢帧问题,该芯片的接收FIFO只能存两帧,发送是三个buffer。同时测试22%负载率就会报MCP2515接收缓冲区满的错误帧。
SPI速率10MHz,CAN波特率500K。
2. 分析
2.1 SPI-CAN原理
该芯片读取单帧CAN报文需要进行4次SPI传输,SPI物理通信时线程会陷入睡眠,直到被SPI中断唤醒,所以会导致MCP2515缓冲区满的罪魁祸首是调度延时。
原驱动常规接收一帧CAN报文需要4次SPI传输:
-
mcp251x_read_2regs(CANINTF) 读取 4 字节:读取中断标志 CANINTF 和错误标志 EFLG
-
mcp251x_hw_rx_frame() 读取 14 字节:使用 READ_RXB 指令一次性读取整个 RX Buffer
-
mcp251x_read_2regs(CANINTF) 读取 4 字节:再次读取中断标志(可能RX1又有数据)
-
mcp251x_read_2regs(CANINTF) while循环里再读取4 字节
如果对端大批量发送CAN报文,MCP2515出现RX0和RX1同时有数据,并且第一次SPI传输读取到RX0IF=RX1IF=1后,读取两帧CAN报文就只需要SPI传输五次。
2.2 驱动侧对收发函数的设置
接收逻辑放在了mcp251x_can_ist中断函数里,同时该中断为线程化中断;
发送逻辑为使用了工作队列,当需要发送时就唤醒该工作队列。
3. 优化驱动
既然问题出在调度延时,那么就有两个思路,一:减少SPI传输次数;二:减少调度延时。
SPI传输次数是不能减少了,否则驱动就会不稳定,无法处理非常规情况。
如何减少调度延时?
3.1 提高接收和发送函数的优先级
需要合理配置应用层与SPI-CAN通讯线程的优先级!
发送逻辑由工作队列改为内核态工作队列,使用SCHED_FIFO且优先级设置很高,绑定到CPU2核心运行:
priv->tx_worker = kthread_create_worker(0, "mcp251x_tx_%s",
dev_name(&spi->dev));
if (IS_ERR(priv->tx_worker)) {
ret = PTR_ERR(priv->tx_worker);
priv->tx_worker = NULL;
goto error_probe;
}
{
struct sched_param param = { .sched_priority = 91 };
sched_setscheduler(priv->tx_worker->task, SCHED_FIFO, ¶m);
set_cpus_allowed_ptr(priv->tx_worker->task, cpumask_of(2));
}
kthread_init_work(&priv->tx_work, mcp251x_tx_work_handler);接收逻辑由线程化中断优化为使用SCHED_FIFO且优先级设置很高,绑定到CPU3核心运行:
ret = request_threaded_irq(spi->irq, NULL, mcp251x_can_ist,
flags | IRQF_ONESHOT, dev_name(&spi->dev),
priv);
if (ret) {
dev_err(&spi->dev, "failed to acquire irq %d\n", spi->irq);
goto out_close;
}
{
struct irq_desc *desc = irq_to_desc(spi->irq);
if (desc && desc->action && desc->action->thread) {
struct sched_param param = { .sched_priority = 91 };
sched_setscheduler(desc->action->thread,
SCHED_FIFO, ¶m);
set_cpus_allowed_ptr(desc->action->thread,
cpumask_of(3));
}
}用ftrace抓取事件发现SPI-CAN通讯中除了接收、发送线程,还涉及到了spi0线程,该线程用于spi传输完成后处理队列和spi控制器空闲时清理资源。
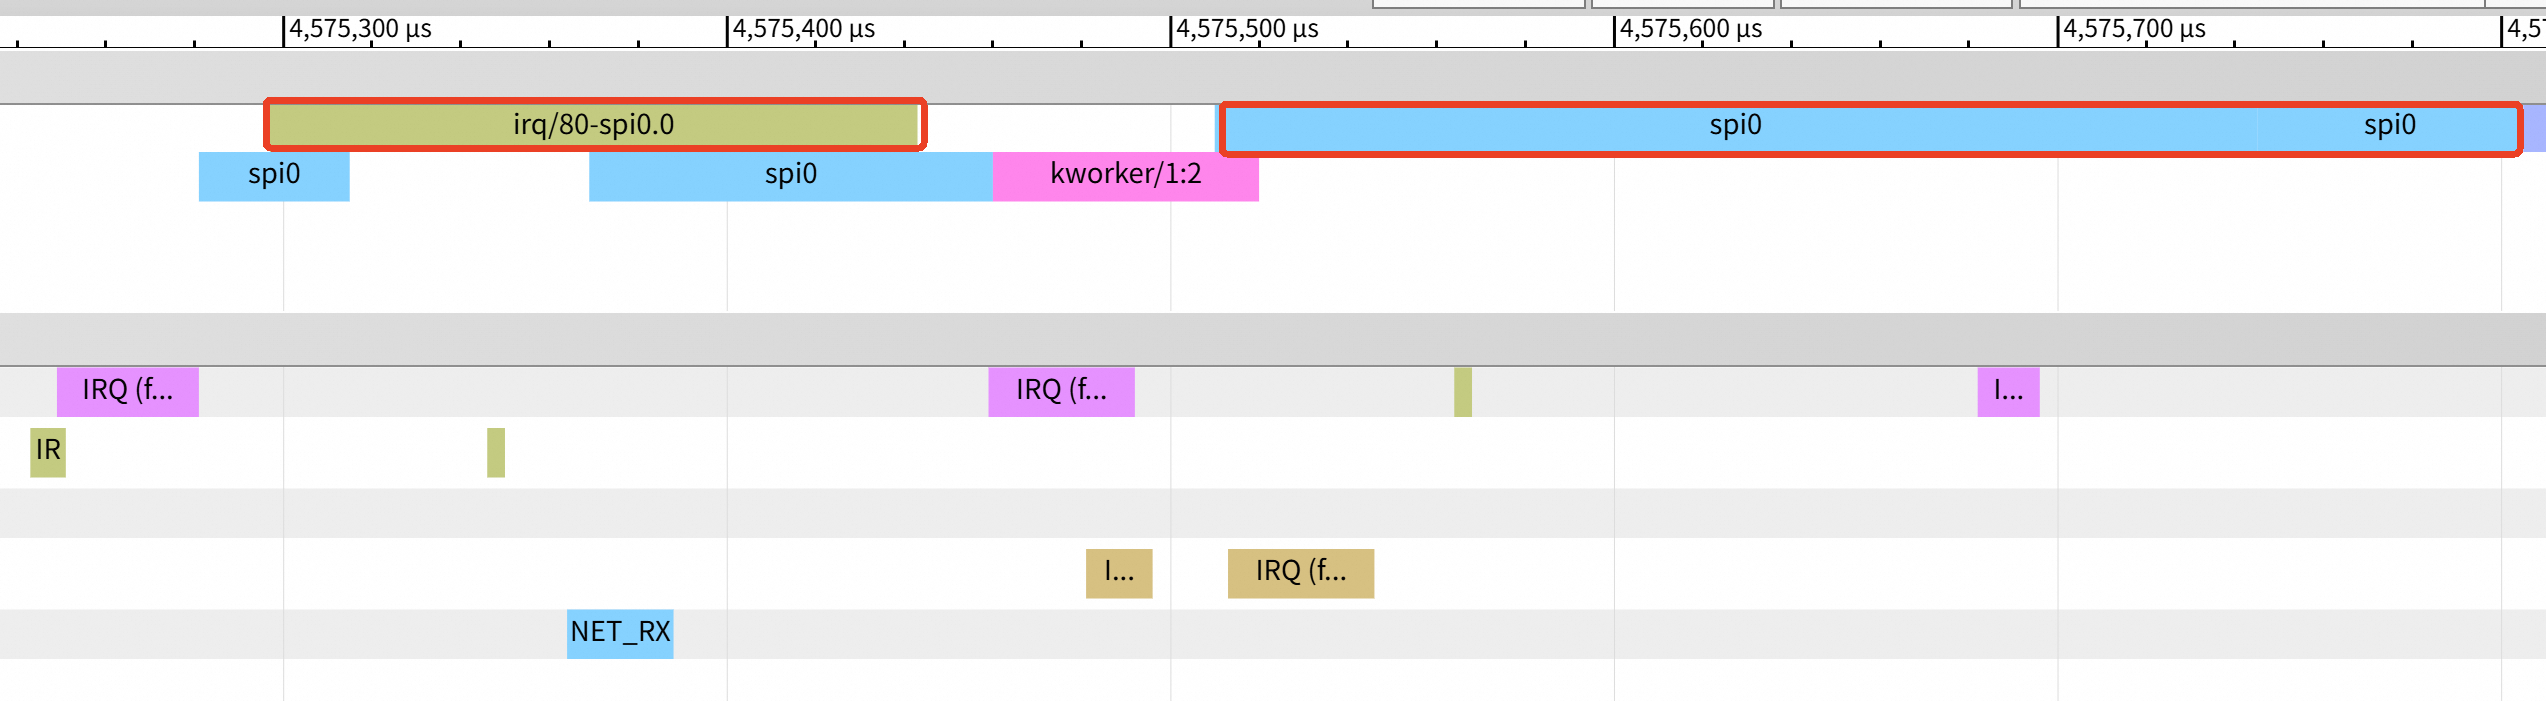
该spi0线程默认是SCHED_OTHER调度,优先级为PR 120。优先级太低也会导致SPI-CAN效率低从而接收丢帧。所以,在设备树中对spi0节点加上 rockchip,rt;,这样在spi_probe时就会设置ctlr->rt=true,从而设置spi0线程为SCHED_FIFO,优先级PR -51。若后续还是有丢帧情况发生,可将优先级提高。
static int rockchip_spi_probe(struct platform_device *pdev)
{
    ......

    ctlr->rt = device_property_read_bool(&pdev->dev, "rockchip,rt");

    ......
}
&spi0 {
status = "okay";
rockchip,rt;
mcp2515: mcp2515@0 {
......
};
};3.2 打上RT补丁
RT补丁目的是让Linux更实时,能够极大的减少调度延时。RT-Linux主要是将自旋锁改为可抢占的互斥锁,将硬件中断线程化,变成一个可抢占的内核。同时,还需要将CPU由动态调频改为定频最高频,系统时钟中断由动态调整改为1000Hz。
4. 结果
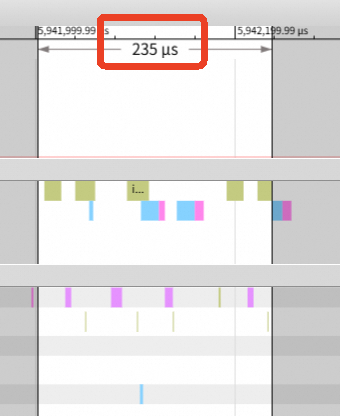
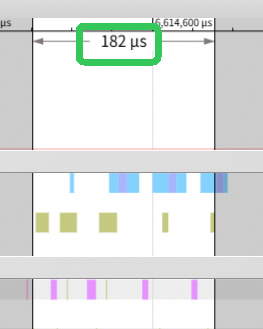
通过ftrace抓取事件,结果显示:用原生CAN,接收一帧耗时16us;优化前SPI-CAN接收一帧耗时235us,优化后182us。
欢迎加入 MCP 技术社区!与志同道合者携手前行,一同解锁 MCP 技术的无限可能!
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)